VeloxQuant-MLX

VeloxQuant-MLX

在 Mac 上以更少内存运行更大的本地 LLM

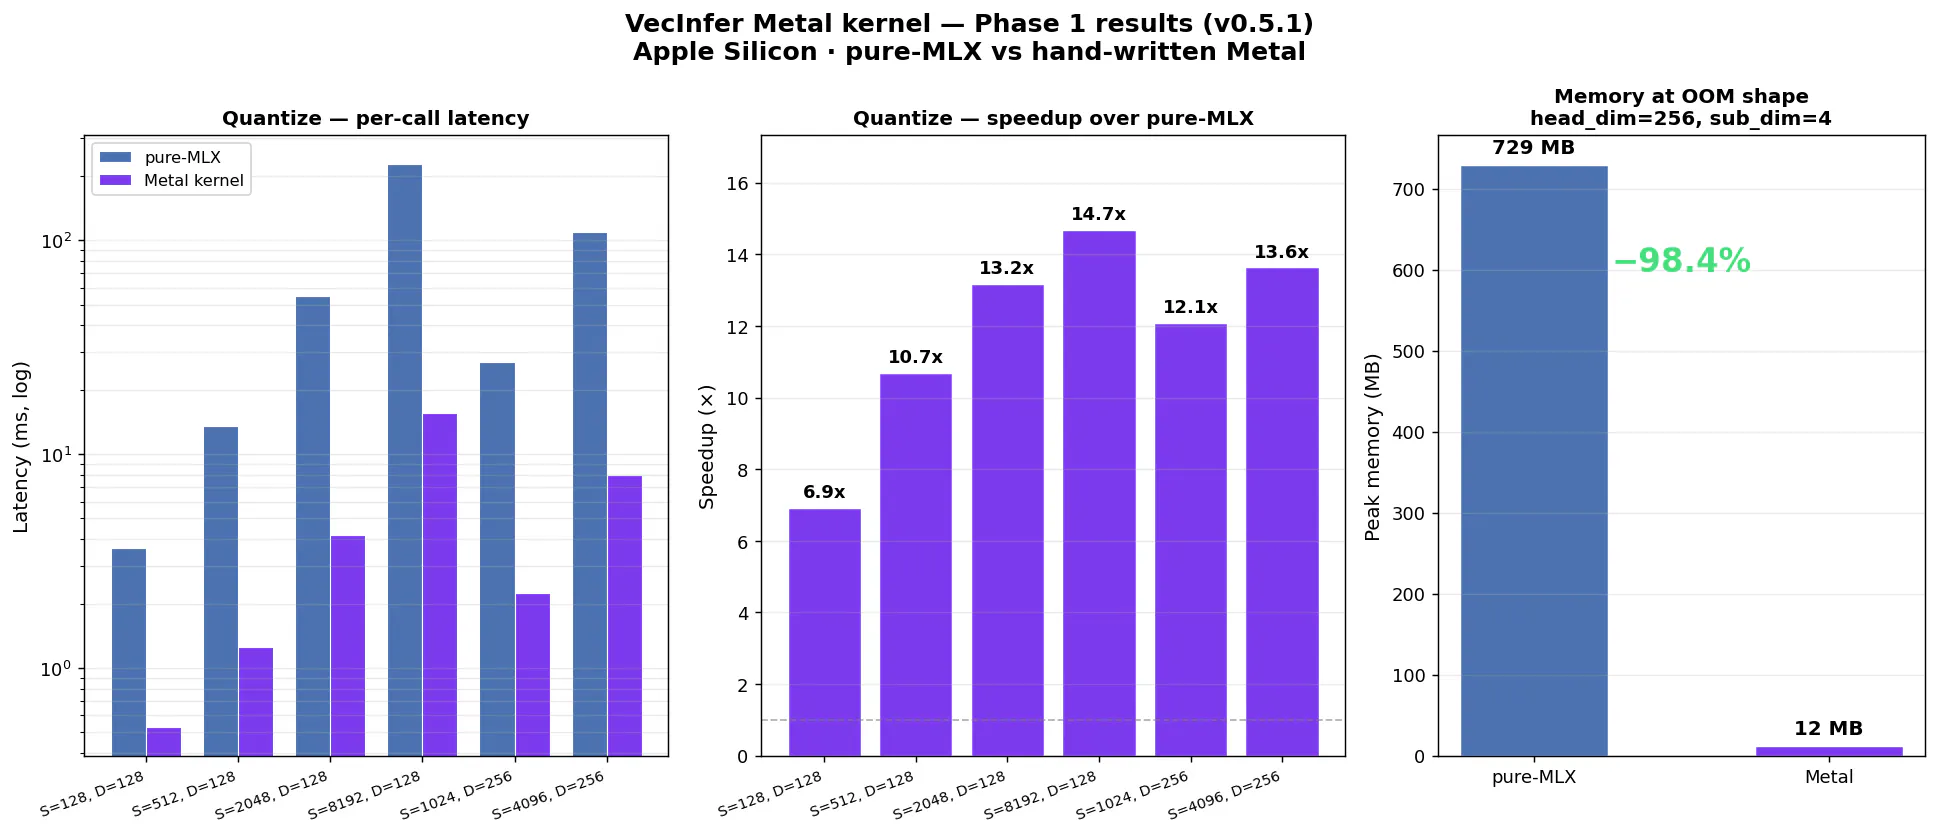
VeloxQuant 让您可以在更少内存中运行更大的本地 AI 模型,完全私密,无需云服务。一个简单的 API 可将内存使用量压缩高达 16 倍,同时在 Apple Silicon 上保持生成速度。

Open SourceDeveloper ToolsArtificial IntelligenceGitHub
👍 2 💬 1 评论 🕐 2026年9月7日
广告位 (响应式横幅)

💬 用户评论

该工具在 Product Hunt 上有 1 条评论。

在 Product Hunt 上查看评论 →

📋 基本信息

上线日期
2026年9月7日
点赞数
2
评论数
1
数据来源
网络公开数据
广告位 (响应式横幅)

🔗 相关推荐